
Предварительный анализ данных
Прежде всего, имеющиеся данные в формате csv были загружены в среду разработки с помощью модуля библиотеки pandas, функции pandas.read_csv. Первым шагом в подготовке данных для анализа было изучение переменных на количество недостающих данных. В изначальных данных все ситуации отсутствия информации по записи обозначались через «?», таким образом, чтобы выявить все пропуски был произведен подсчет значений, равных «?» по каждому из параметров. Ниже приведены параметры, с полученными значениями процента недостающих данных: раса - 2%; вес - 97%; страховая компания - 40%; отделение, в которое поступил пациент - 49%; дополнительный вторичный диагноз - 1%. В связи с большим количеством пропусков, переменные вес, страховая компания и отделение были исключены из анализа, так как не предоставляется возможным с помощью методов исключения шумов из выборки заполнить значениями недостающие данные. Недостающая информация для расы и дополнительного вторичного диагноза была заполнена искусственно, используя подстановку значения медианы по данным параметрам из всей имеющейся выборки.
Далее, был проведен анализ выбросов по оставшимся параметрам с помощью boxplot, который показывает медиану выборки, максимальное и минимальное значение, верхний и нижний квартили, а также выбросы. Например, переменная возраста имеет один выброс, который, учитывая размер выборки не влияет на качество предсказаний с использованием данного параметра, а, значит, возраст можно учитывать при анализе (см. рис. 2, 3, 4):
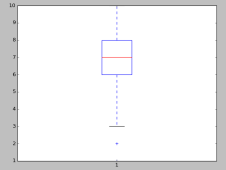
Рисунок 2. BoxPlot для переменной «Возраст»
В ходе данного анализа были выявлены две переменные с большим количеством выбросов, которые влияют на качество работы модели - дополнительный вторичный диагноз и прием росиглитазона:
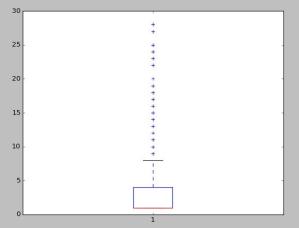
Рисунок 3. BoxPlot для переменной «Прием росиглитазона»
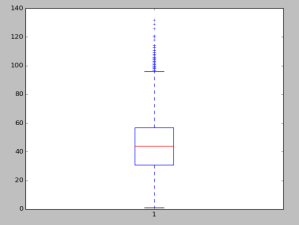
Рисунок 4. BoxPlot для переменной «Дополнительный вторичный диагноз»
Большое количество выбросов для дополнительного вторичного диагноза может быть объяснено тем, что данная графа в карте пациента является обязательной для заполнения, но считается многими врачами второстепенной, в связи с чем заполняется не всегда корректно. Прием росиглитазона в свою очередь может объясняться некорректным сбором данных из анкет пациентов, так как по умолчанию данная переменная должна принимать только два значения - 0 (в случае, если лекарство не принимается) и 1 (в случае, если больной принимает данный медикаментозный препарат). Как можно увидеть на графике, значение этой переменной колеблется от 0 до 30, что говорит о некорректности данных. Дополнительный вторичный диагноз и прием росиглитазона были исключены из дальнейшего анализа и построения модели на основании проведенного анализа.
По результатам обнаружения выбросов, а именно результатов, связанных с переменной «прием росиглитазона» было принято решение проверить валидность данных. Для этого из каждого параметра были выбраны уникальные значения (удалены дубликаты), которые были сопоставлены с областью значений для данных переменных. В результате данного анализа не было выявлено ни одного параметра с невалидными значениями.
Далее, был проведен анализ влияния поставленных диагнозов на результат реадмиссии, было выявлено, что заболевания, относящиеся к одной группе в классификации ICD9 имеют примерно одинаковую степень влияния на зависимую переменную. Поэтому, было принято решение, искуственно заменить коды заболеваний на коды групп, соответственно 1 для заболеваний группы инфекционных и паразитарных заболеваний, 2 - новообразования и так далее.
Следующим шагом был проведен анализ one-way ANOVA, позволяющий определить корреляцию переменных между собой. В Python данный метод реализуется с помощью библиотеки scipy, модуля stats, функции f_oneway. Данный метод на входе запрашивает наименования параметров, между которыми необходимо определить статистическую значимость, а на выходе возвращает значения f-value (F-критерий Фишера) и p-value (вероятность ошибки первого рода). Полученное f-value сравнивается с табличным значением F, в случае, если фактическое F меньше, чем F табличное, то это показывает ненадежность выбранной модели регрессии и низкое качество предсказаний. Табличное значение F равно 0.98 (k1 - количество факторов = 47, k2 - количество наблюдений-количество факторов 101720, уровень значимости - 0,05), полученное с помощью ANOVA значение равно 17.55, соответственно модель можно признать статистически значимой. Для окончательного подтверждения возможности использовать оставшиеся параметры для построения модели, необходимо сравнить полученное p-value с уровнем значимости, выбранным для модели. P-value = 0.15, уровень значимости равен 0,01, так как p-value больше уровня значимости, модель можно принять и использовать все, неисключенные до этого из анализа переменные.
После проделанных выше шагов данные готовы к использованию в построении модели. Как уже было сказано выше, для обучения модели будут использоваться следующий методы - рандомный лес, метод k-блиажйших соседей, логистическая регрессия и наивный баесовский классификатор. Данные методы будут применены к обучающей выборке, составляющей 80% от имеющихся данных, результат их работы проверен на тестовой выборке, составляющей оставшиеся 20%. Прежде, чем применять методы к данным, необходимо выбросить из выборки параметры, которые на предыдущих шагах были исключены из анализа, а также целевую переменную (readmitted) и параметры, представляющие собой id пациента и визита.
train = diabetic_data.drop(['weight', 'payer_code', 'patient_nbr', 'encounter_id', 'diag_3', 'rosiglitazon', 'readmitted'], axis=1)